OCR de PDF e imágenes
Saca el texto de escaneos y fotos — nada sale de tu navegador.
¿Qué quieres hacer?
OCR — reconocimiento de texto
Tus archivos se quedan en tu navegador y nunca se suben: extrae el texto de tu documento con un clic sin dejar huella digital. Convierte el texto de PDF escaneados o fotos en texto editable.
Cómo funciona
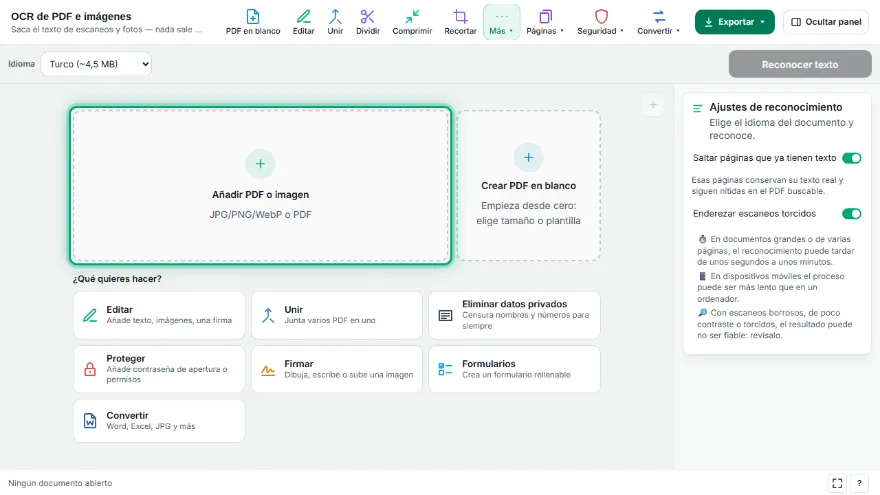
- 1
Sube tu archivo
Elige un PDF escaneado o una foto.
- 2
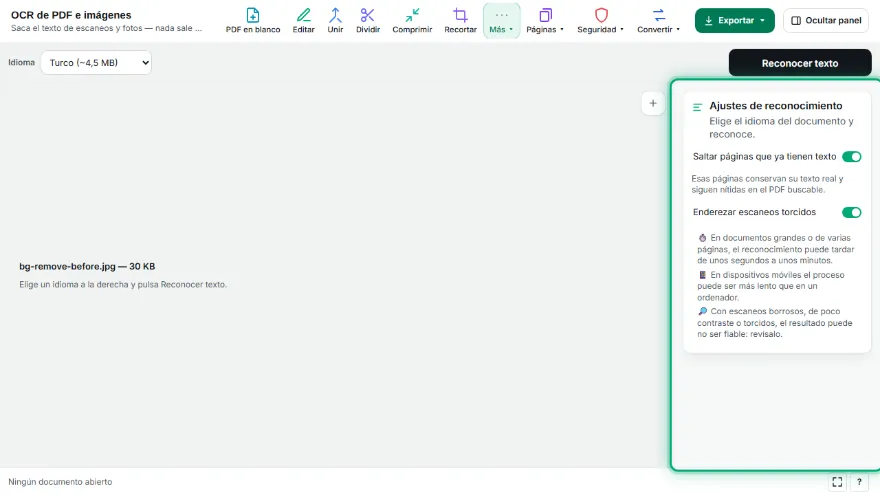
Elige un idioma
Elige el idioma del documento (turco por defecto): solo se descarga el paquete de ese idioma.
- 3
Reconoce
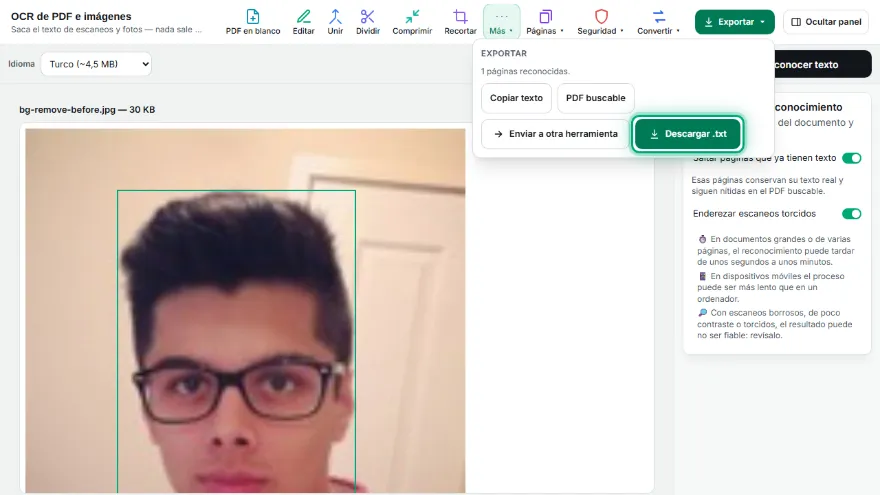
El texto se reconoce en tu navegador y el resultado aparece como texto editable.
- 4
Descarga
Descárgalo en .txt o como PDF buscable (con capa de texto).
Características
- ✓8 idiomas: turco, inglés, alemán, francés, español, italiano, ruso y árabe
- ✓Los paquetes de idioma se guardan en el navegador tras el primer uso y no se vuelven a descargar
- ✓El resultado sale como texto editable, descargable en .txt
- ✓Genera un PDF buscable (con capa de texto)
- ✓Indicador de progreso página a página para PDF de varias páginas
- ✓Funciona por completo en tu navegador: tu documento nunca se sube
Preguntas frecuentes
¿Los paquetes de idioma se descargan cada vez?
No: tras la primera descarga se guardan en tu navegador y no se vuelven a descargar en los usos siguientes.
¿Qué precisión tiene el resultado?
Depende de la calidad de la imagen: los escaneos nítidos, rectos y con buen contraste dan el mejor resultado. Revisa siempre el resultado en imágenes borrosas o torcidas.
¿Qué idiomas admite?
Turco e inglés en la selección principal; además alemán, francés, español, italiano, ruso y árabe en "Más idiomas".