PDF & Görüntü OCR
Taramalardan ve fotoğraflardan metni çıkarın — hiçbir şey tarayıcınızdan çıkmaz.
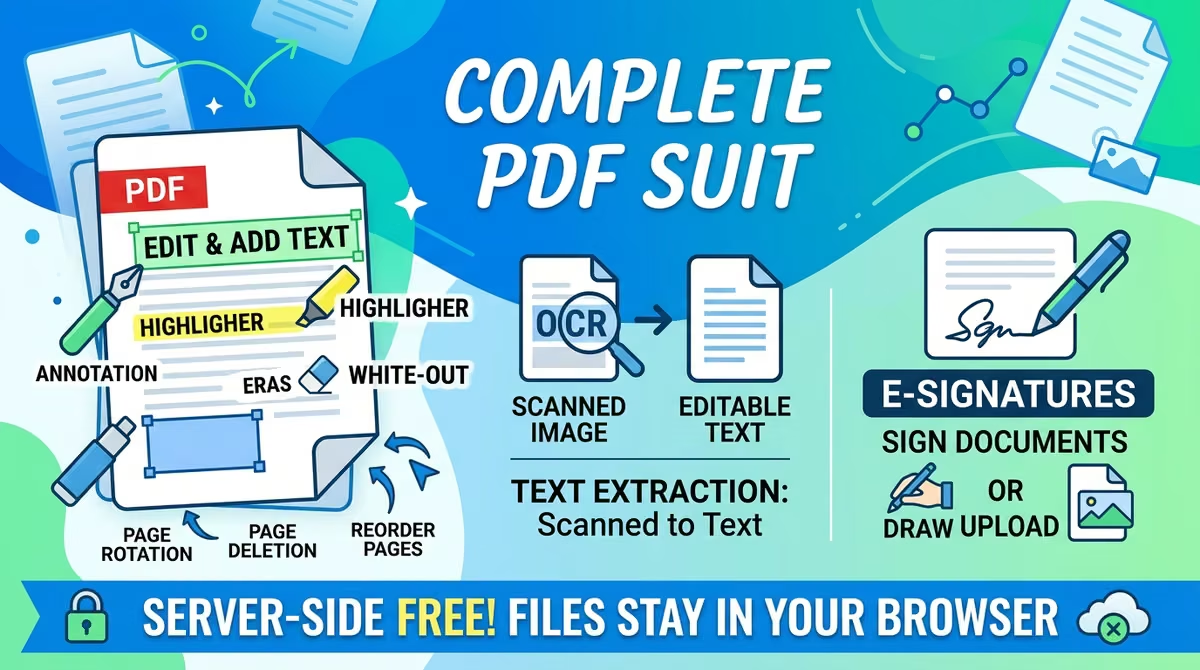
OCR — Metin Tanıma
Dosyalarınız tarayıcınızda kalır, hiçbir yere gönderilmez — dijital ayak izi bırakmadan, tek tıkla belgenizdeki metni çıkarın. Taranmış PDF veya fotoğraflardaki metni düzenlenebilir hale getirin.
Nasıl Yapılır?
- 1
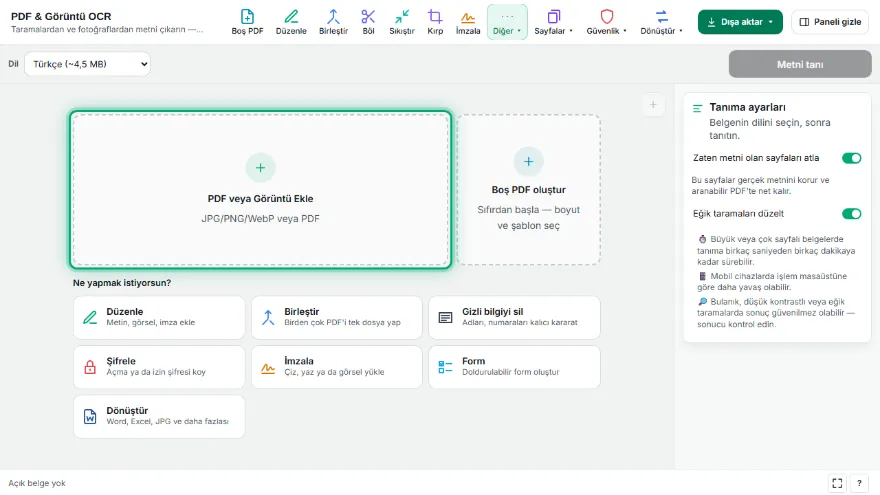
Dosyanızı yükleyin
Taranmış bir PDF veya fotoğraf seçin.
- 2
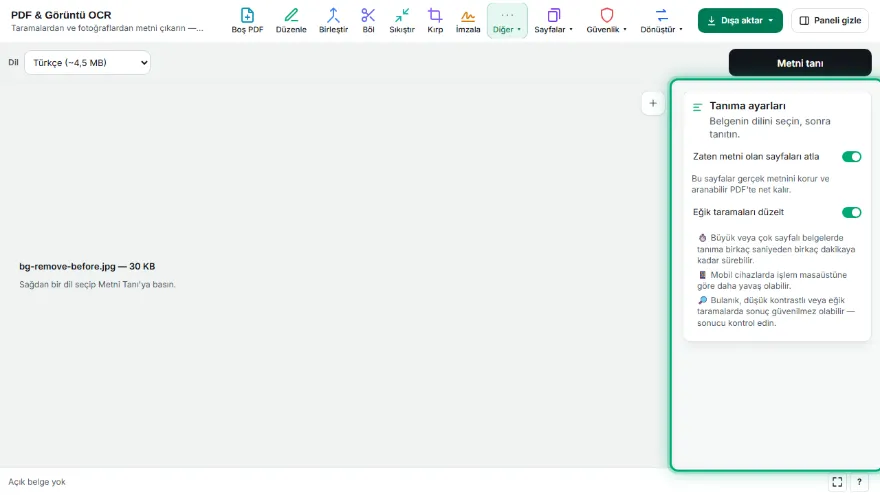
Dili seçin
Belgenin dilini seçin (Türkçe varsayılan) — sadece o dilin paketi indirilir.
- 3
Tanıma yapın
Metin tarayıcınızda tanınır, sonuç düzenlenebilir olarak görünür.
- 4
İndirin
.txt olarak veya aranabilir (metin katmanlı) PDF olarak indirin.
Özellikler
- ✓8 dil desteği: Türkçe, İngilizce, Almanca, Fransızca, İspanyolca, İtalyanca, Rusça, Arapça
- ✓Dil paketleri ilk kullanımdan sonra tarayıcıda önbelleğe alınır — tekrar indirilmez
- ✓Sonuç düzenlenebilir metin olarak çıkar, .txt indirilebilir
- ✓Aranabilir (metin katmanlı) PDF çıktısı üretme
- ✓Çok sayfalı PDF'lerde sayfa sayfa ilerleme göstergesi
- ✓Tamamen tarayıcıda çalışır — belgeniz sunucuya yüklenmez
Sıkça Sorulan Sorular
Dil paketleri her seferinde yeniden mi indiriliyor?
Hayır, ilk indirmeden sonra tarayıcınızda önbelleğe alınır, sonraki kullanımlarda tekrar indirilmez.
Sonuç ne kadar doğru?
Görüntü kalitesine bağlıdır — net, düz ve yeterli kontrastlı taramalarda en iyi sonucu verir. Bulanık veya eğik görüntülerde sonucu mutlaka gözden geçirin.
Hangi diller destekleniyor?
Türkçe ve İngilizce ana seçimde; ayrıca Almanca, Fransızca, İspanyolca, İtalyanca, Rusça ve Arapça "Daha fazla dil" altında.